

表徵映射(Representation Mapping)
摘要
表徵映射(representation mapping)指將輸入資料轉換為另一種表示形式(representation)的運算,其目的在於改變資料的幾何結構(geometric structure)與語義結構(semantic structure),使模型能更有效地進行學習與推論。
在機器學習(machine learning)中,原始資料通常無法直接形成可分離(separable)或可建模(modelable)的結構,因此需透過映射進入適當的表示空間(representation space)。此過程本質上是從原始特徵中提取更高層級的潛在表示(latent representations),使資料關係在新空間中變得更具結構性。
表徵映射通常位於模型中間層(hidden layers),負責建立模型內部的語義空間(semantic space),並形成從輸入到決策之間的核心轉換鏈:
輸入資料 → 表徵映射 → 潛在表示 → 機率映射 → 決策機制
因此表徵映射可視為模型的「特徵形成(feature formation)」過程,其角色是將原始資料轉換為適合後續推論的表示形式。
基本形式
若模型僅包含線性映射(linear mappings),則多層結構可被等價化簡為單一線性轉換,因此無法有效提升模型表達能力(expressiveness)。深度學習(deep learning)之所以能處理複雜問題,核心原因之一即在於引入非線性映射(nonlinear mappings),使模型能形成複雜決策邊界(decision boundaries)。
ReLU(Rectified Linear Unit)是最常見的非線性映射之一:
其透過截斷負值形成稀疏性(sparsity),並減少梯度消失(vanishing gradient)問題,因此成為現代深度神經網路中的標準映射函數。
tanh(hyperbolic tangent)則將輸出限制於 區間:
其具有中心化(zero-centered)特性,有助於優化穩定性,但在深層網路中仍可能產生梯度消失。
Sigmoid 函數亦可作為隱層映射:
然而由於梯度在極端區域接近零,現代深度網路已較少將 sigmoid 作為主要隱層映射函數。
除了 activation functions 外,表徵映射亦可包含嵌入映射(embedding transformations)、核函數(kernel functions)與投影操作(projection operations)等更高階形式,其共同目標皆是形成更具語義結構的表示空間。
表示空間與模型角色
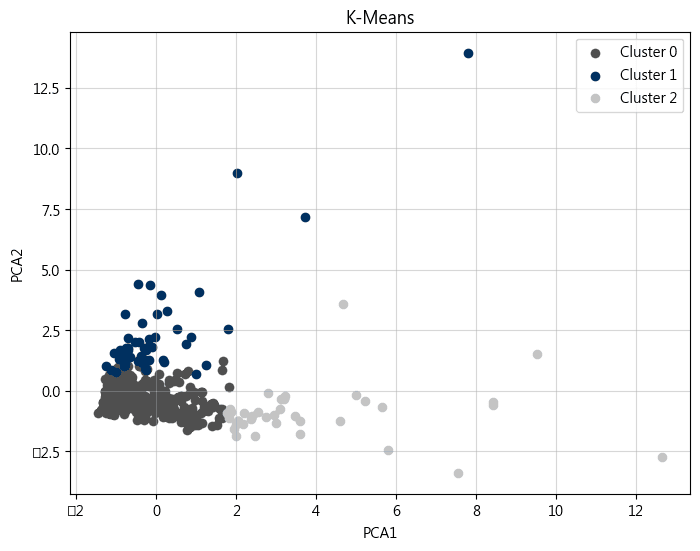
表徵映射的結果是形成潛在空間(latent space),其中資料之間的關係會以更有組織的方式呈現。例如在分類問題中,不同類別可能於潛在空間形成可分離群集(separable clusters),使後續分類更容易完成。
在表示學習(representation learning)中,模型的核心目標即是學習有效的表徵映射,使下游任務(downstream tasks)能在較高層級表示上進行推論。
從更一般的視角來看,表徵映射可視為從原始資料空間(raw data space)到語義表示空間的結構轉換,其角色是將低層訊號逐步轉化為可推論、可分離且具任務意義的高階表示。