

評估策略(Evaluation Strategy)
定義與角色
評估策略(evaluation strategy)描述如何在有限資料條件下設計模型評估流程,使評估結果能夠反映模型在未見資料(unseen data)上的泛化能力(generalization)。與評估指標(evaluation metrics)不同,評估策略不直接量化結果,而是決定如何產生這些結果。
在機器學習(machine learning)中,若缺乏合理的資料切分方式,評估指標即使數值正確,也可能無法代表模型的真實表現。
資料切分的基本形式
模型評估建立在訓練資料(training data)與驗證資料(validation data)之間的區分。最基本形式為將資料劃分為兩部分,其中一部分用於訓練模型,另一部分用於評估模型。
此方法雖然簡單,但評估結果高度依賴單次切分,容易受到資料分佈偶然性的影響,導致評估偏差(evaluation bias)。
交叉驗證(Cross Validation)
交叉驗證(cross validation)是一種透過多次資料切分來降低評估偏差的方法。其核心思想是重複使用資料,使每一筆樣本都能參與模型訓練與評估,從而獲得較穩定的性能估計。
相較於單次切分,交叉驗證提供的是對模型表現的期望估計,而非單一結果。
K 折交叉驗證(K-Fold Cross Validation)
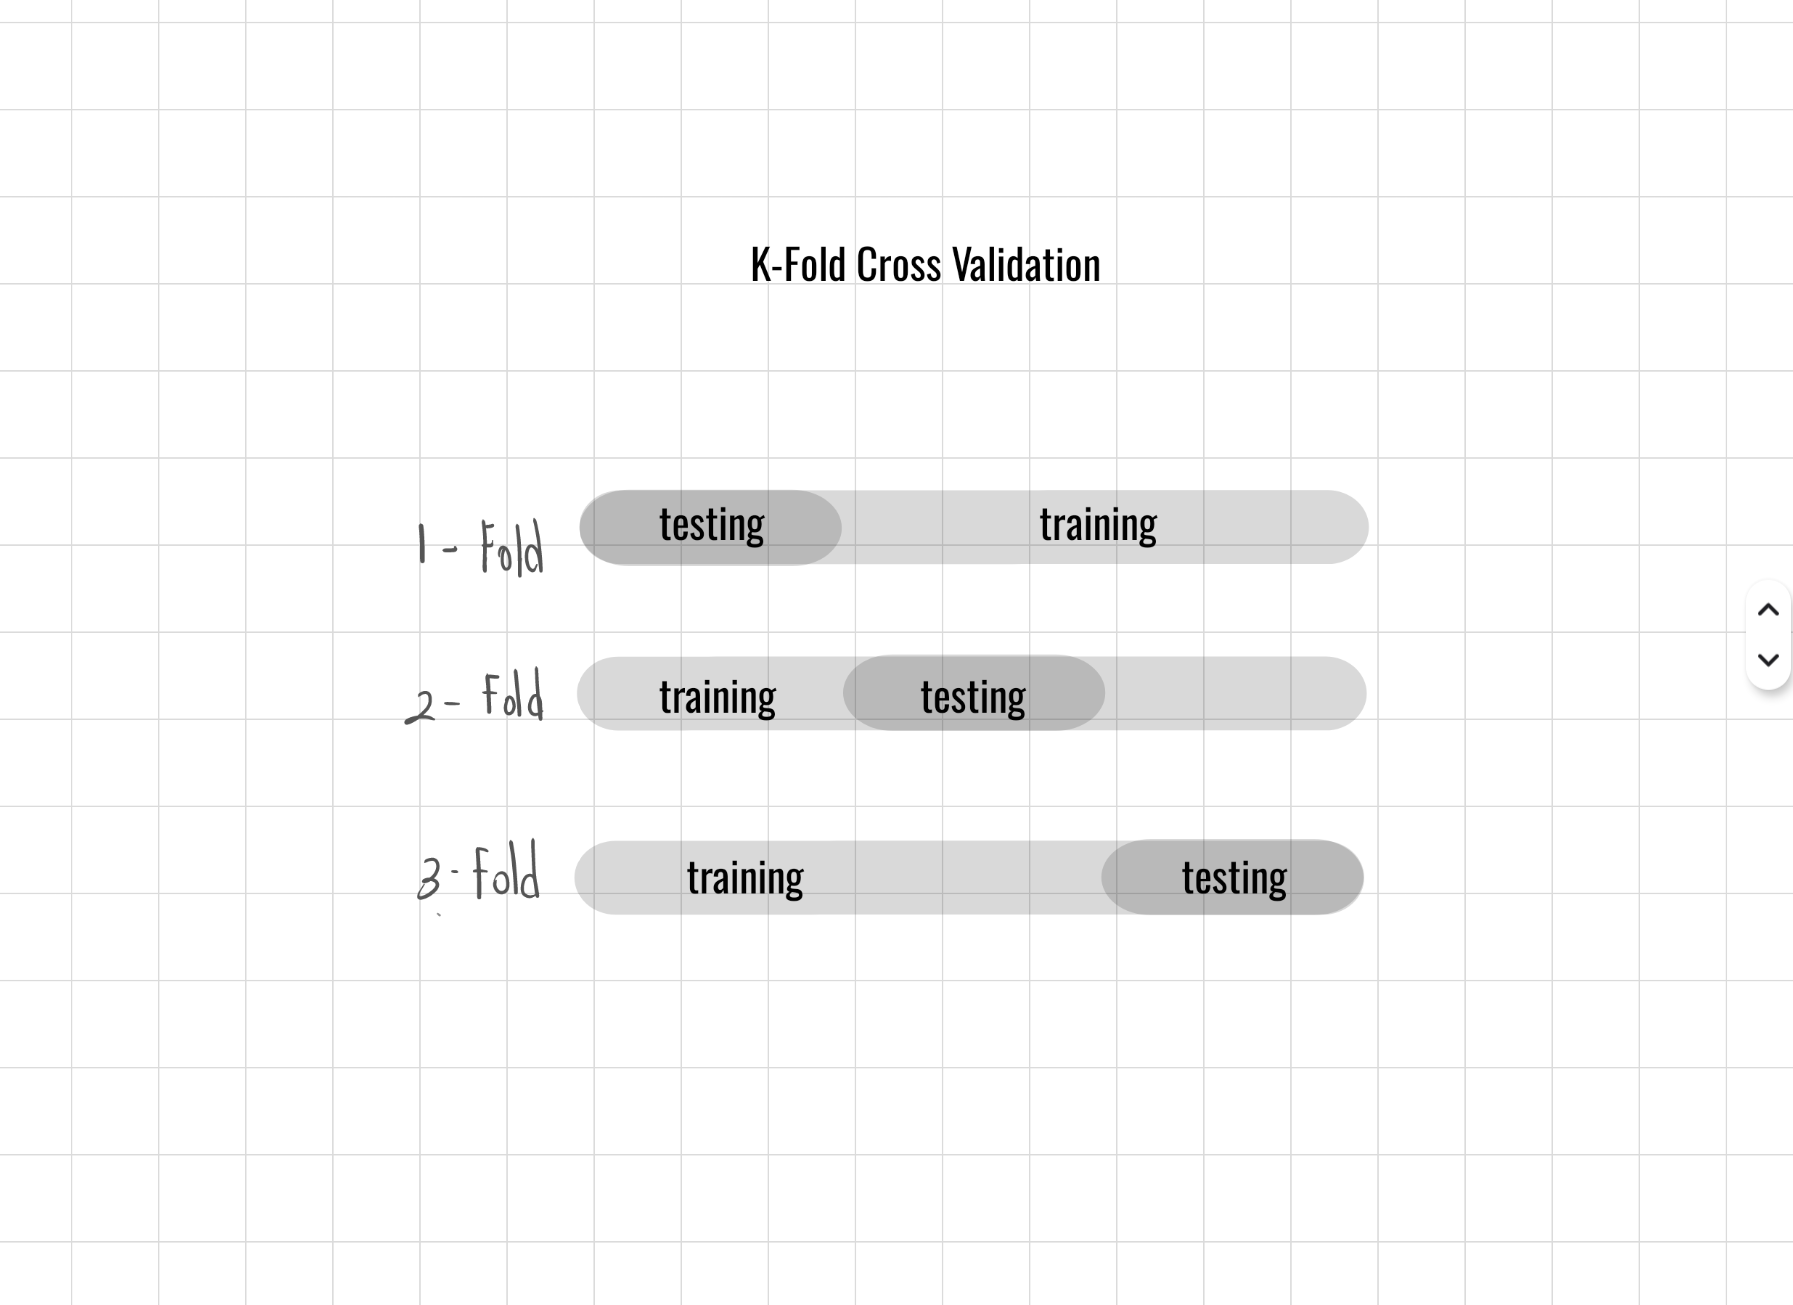
K 折交叉驗證(K-fold cross validation)將資料集劃分為 個子集合(folds),並進行 次訓練與評估。每次選取其中一個子集合作為驗證集,其餘子集合作為訓練集,使每個子集合皆能作為一次驗證資料。
此方法在有限資料情境下能有效降低評估偏差,並提升結果穩定性。
K 值選擇
常見設定為 或 。較小的 將增加偏差(bias),較大的 則可能增加變異(variance)與計算成本,因此需在穩定性與效率之間取得平衡。
評估流程
將資料集平均切分為 個子集合,每次選擇其中一個作為驗證集,其餘作為訓練集,重複進行 次訓練與評估,使所有資料皆被使用於驗證。最終結果由多次評估組合而成,而非單一測量。
結果彙整
交叉驗證的結果通常以平均值與標準差表示,用以反映模型表現的期望與穩定性。
平均得分:
標準差:
最終結果可表示為:
其中平均值反映整體性能,標準差則描述模型在不同資料切分下的變動程度。
與評估指標的關係
評估策略決定資料如何被使用,而評估指標決定結果如何被量化。兩者分別對應評估過程中的不同層級,需同時設計才能得到可靠的模型評估結果。
若缺乏適當的評估策略,即使使用精確的指標,也可能得到具有偏差的結論。