

聚合與池化(Aggregation & Pooling)
摘要
聚合與池化(aggregation & pooling)指將多個輸入表示(representations)整合為單一摘要表示(summary representation)的運算,其核心目的在於壓縮資訊(information compression)、整合上下文(context integration)與形成全局特徵(global features)。
與表徵映射(representation mapping)不同,聚合不著重於改變單一元素的表示形式,而是從多個表示中提取整體結構。因此表徵映射屬於單元素轉換(element-wise transformation),聚合則屬於多表示整合(multi-representation integration)。
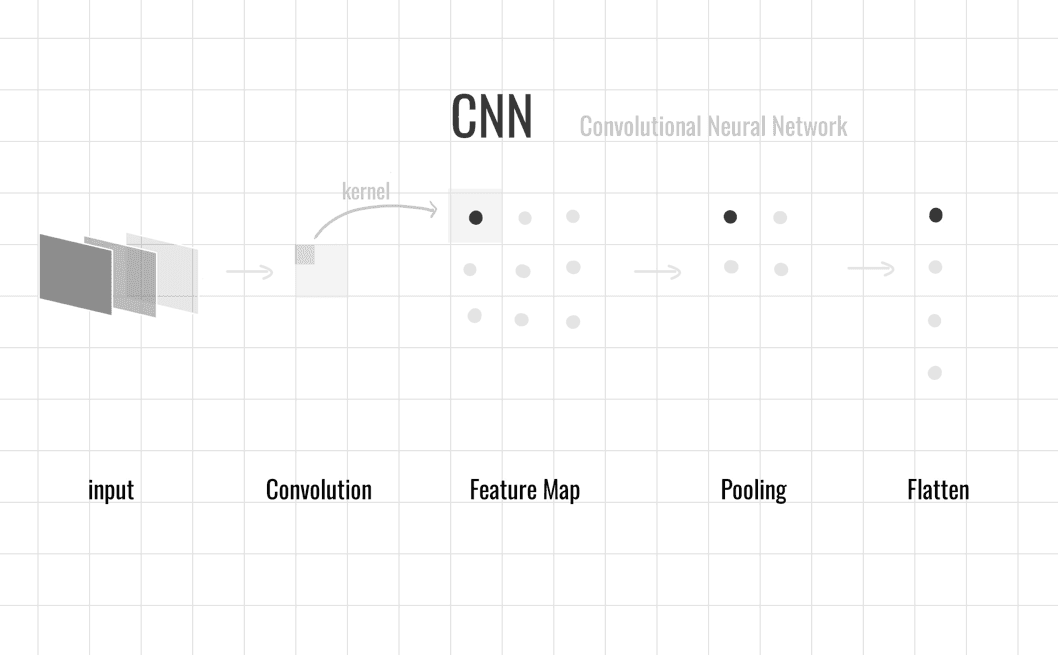
在神經網路(neural networks)中,聚合通常位於局部特徵與全局表示之間,負責將分散資訊壓縮為可供後續推論的高階表示。卷積神經網路(convolutional neural networks, CNN)利用聚合整合空間資訊,圖神經網路(graph neural networks, GNN)利用聚合整合鄰居節點,而 Transformer 則透過注意力(attention)機制整合序列上下文。
基本形式
池化(pooling)是最基本的聚合形式,其透過固定函數將多個數值壓縮為單一值。最大池化(max pooling)保留最強訊號,偏向極值特徵;平均池化(mean pooling)則保留整體統計趨勢。此類方法不依賴可學習參數(learnable parameters),因此具有固定資訊偏好。
注意力聚合(attention aggregation)則透過加權總和(weighted sum)整合輸入,其中權重由模型學習而得,使不同元素對最終表示具有不同貢獻程度。相較於固定池化,注意力機制能根據上下文動態選擇重要資訊,因此成為 Transformer 架構中的核心運算。
在集合函數(set functions)與圖結構模型中,聚合需滿足排列不變性(permutation invariance),即輸入順序不影響輸出結果。因此常使用加總(sum)、平均(mean)與最大化(max)等交換性運算(commutative operations)形成集合表示。
資訊壓縮與模型角色
聚合本質上是一種資訊壓縮機制。模型透過有限維度的摘要表示保留關鍵特徵,同時捨棄部分局部細節,以降低計算成本並提升模型穩定性。
不同聚合方式代表不同資訊保留偏好。最大池化偏向顯著訊號,平均池化偏向整體分佈,而注意力聚合則偏向任務相關的重要資訊。因此聚合策略本身即反映模型對資訊重要性的結構假設。
從更一般的視角來看,聚合可視為從集合(set)或序列(sequence)中提取全局摘要的操作,其角色是將局部訊號轉換為較高層級的整體表示,並作為後續推論與決策的基礎。